AI를 앱에 넣는 다섯 갈래
2026년 8월 25일
* 값은 2026년 8월 기준입니다.
다섯 가지
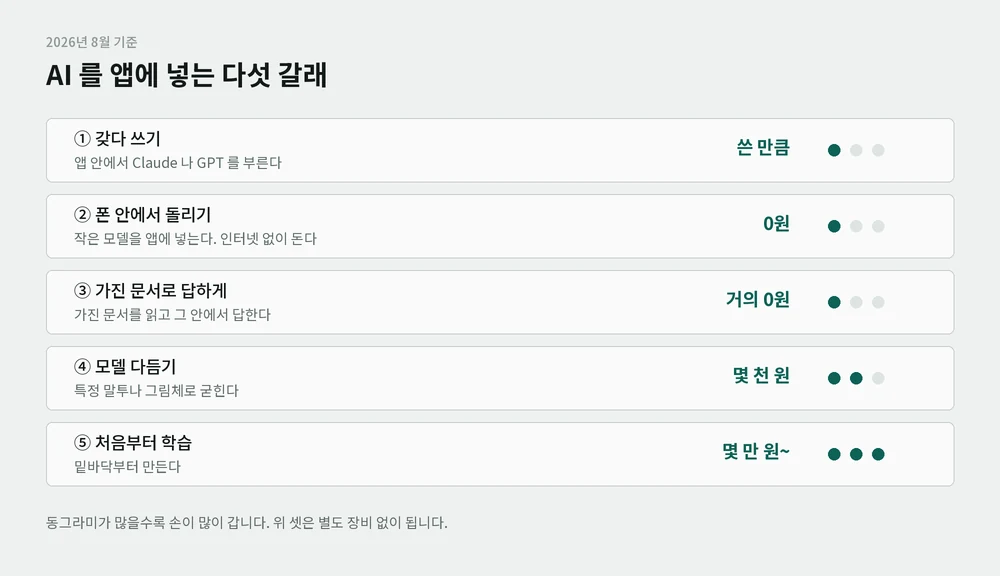
| 무엇 | 값 | |
|---|---|---|
| ① 갖다 쓰기 | 앱 안에서 Claude나 GPT를 부른다 | 쓴 만큼. 한 번에 몇 원 |
| ② 폰 안에서 돌리기 | 작은 모델을 앱에 넣는다. 인터넷 없이 돈다 | 0원 |
| ③ 가진 문서로 답하게 (RAG) | 가진 문서를 읽고 그 안에서 답한다 | 거의 0원 |
| ④ 모델 다듬기 (파인튜닝·LoRA) | 특정 말투나 그림체로 굳힌다 | GPU 몇 시간. 몇 천 원 |
| ⑤ 처음부터 학습 | 밑바닥부터 만든다 | 분류·추천은 몇 만 원. 큰 언어모델은 개인이 못 한다 |
아래로 갈수록 어렵습니다. 별도 장비 없이 되는 건 위 세 가지까지.
① 갖다 쓰기
앱이 서버를 거쳐 AI를 부르고 답을 받아옵니다. 지금 나오는 「AI 앱」 대부분이 이것.
- 막는 것: 사용자 데이터가 앱 밖으로 나갑니다. 개인정보 방침에 그 사실을 적어야 합니다
- 막는 것: 열쇠(API 키)를 앱 안에 넣으면 안 됩니다. 중계 서버가 하나 필요합니다
- 값이 사용량에 비례합니다. 무료 앱에 붙이면 쓰는 사람이 늘수록 손해가 납니다
② 폰 안에서 돌리기
작은 모델을 앱에 함께 넣습니다. 인터넷이 없어도 돌고, 데이터가 폰 밖으로 안 나가는 방식.
앱이 「데이터가 기기 밖으로 나가지 않는다」를 내세우고 있다면, 그 약속을 안 깨고 AI를 넣는 길은 이것뿐입니다. 카메라나 마이크를 쓰는 앱에서 특히 갈립니다.
- 값: 0원
- 막는 것: 앱 용량이 몇백 MB 늘어납니다
- 막는 것: 큰 모델은 안 들어갑니다. 할 수 있는 일이 정해져 있는 쪽
③ 가진 문서로 답하게 (RAG)
모델을 건드리지 않습니다. 질문이 들어오면 가진 문서에서 관련된 대목을 찾아 함께 넘기고, 모델은 그 안에서 답합니다.
- 값: 거의 0원
- 쓸 곳: 문서가 수백 개 쌓인 곳. 사내 자료, 제품 안내, 규정
- 막는 것: 문서를 미리 잘라 정리해두는 작업이 앞에 붙는다는 것
④ 모델 다듬기 (파인튜닝·LoRA)
이미 있는 모델에 자료를 더 먹여 특정 말투나 그림체로 굳힙니다. 그림 쪽에서 LoRA라고 부르는 것이 이것.
- 값: GPU 몇 시간. 아래 값으로 치면 몇 천 원
- 막는 것: GPU가 필요합니다. 없으면 빌리는 수
GPU는 빌립니다
그래픽카드가 없는 것이 ④부터의 벽인데, 시간 단위로 빌릴 수 있습니다. 초 단위로 계산해서 10분 쓰면 10분 값만.
빌리는 곳은 세 갈래이고 값이 꽤 다릅니다.
| 어디서 | 무엇인가 | RTX 4090 시간당 |
|---|---|---|
| 개인에게 | 놀고 있는 그래픽카드를 내놓은 장터 (vast.ai, RunPod Community) | 약 470원 |
| GPU 전문 클라우드 | 그 회사가 검증한 데이터센터 (RunPod Secure, Lambda 등) | 약 950원 |
| 대형 클라우드 | AWS, 구글 클라우드 | 더 비쌉니다 |
A100처럼 더 큰 카드는 시간당 약 1,900원부터.
개인에게 빌린다는 것
게이머, 채굴자, 소규모 연구실이 안 쓰는 시간에 자기 카드를 장터에 올립니다. vast.ai에는 개인 제공자 1,400곳 이상이 GPU 17,000장가량을 올려두고 있습니다.
플랫폼이 가운데서 결제와 격리된 실행 환경을 맡습니다. 남의 컴퓨터에서 코드가 돌아도 그 사람 파일에는 닿지 않습니다. 호스트마다 신뢰도 점수가 붙어 있고, 「호스트가 중간에 끊을 수 있음」 조건을 받으면 절반까지 더 쌉니다.
- 막는 것: 싼 대신 중간에 끊길 수 있습니다. 오래 도는 작업은 중간 저장이 필요합니다
- 막는 것: 남의 기계. 민감한 자료를 올리는 자리가 아닙니다
값이 뜻하는 것
그림 천 장을 밤새 뽑는 일이나 그림체 하나를 굳히는 일이 몇 천 원짜리가 됩니다. 컷마다 크레딧을 먹는 생성 서비스와 셈이 다릅니다.
- 막는 것: 손이 많이 갑니다. 모델 고르기, 설정, 시행착오가 전부 사람 몫입니다
- 시안 몇 장이면 기존 유료 서비스가 빠르고, 대량으로 찍을 때 이쪽이 싸지는 구조
- 근거: RunPod RTX 4090 가격 · vast.ai
⑤ 처음부터 학습
큰 언어모델을 밑바닥부터 만드는 것은 개인이 못 합니다. 다만 작은 것은 됩니다. 분류나 추천처럼 목적이 좁은 모델은 자료만 있으면 몇 만 원 안에서 학습됩니다.
- 막는 것: 자료가 있어야 합니다. 모델보다 자료 모으기가 오래 걸립니다
확인 상태
| 실제로 돌려서 확인 | ②의 로컬 음성 인식·음성 합성. 그래픽카드 없이 3초짜리 한국어를 2.1초에 받아썼습니다 |
| 값과 조건만 조사 | ①·③·④·⑤, GPU 대여 값 |